Współpraca bez udostępniania danych. Nowe wyzwania dla AI
Szybki rozwój sztucznej inteligencji stawia przed naukowcami wiele nowych cyfrowych wyzwań. Jednym z nich są dane rozproszone, chronione w poszczególnych instytucjach. Przykładem takich danych mogą być wyniki badań pacjentów cierpiących na tę samą chorobę zgromadzone w wielu różnych szpitalach. Zebrane razem i przeanalizowane byłyby świetnym źródłem wiedzy dla lekarzy, którzy mogliby dzięki temu szybciej diagnozować i leczyć pacjentów. Nad rozwiązaniem tego problemu pracują doktorantka Katarzyna Kusztal pod okiem dr hab. Małgorzaty Przybyły-Kasperek, prof. UŚ (Wydział Nauk Ścisłych i Technicznych UŚ), we współpracy z prof. Josém Garcíą-Rodríguezem (Uniwersytet w Alicante, Hiszpania).
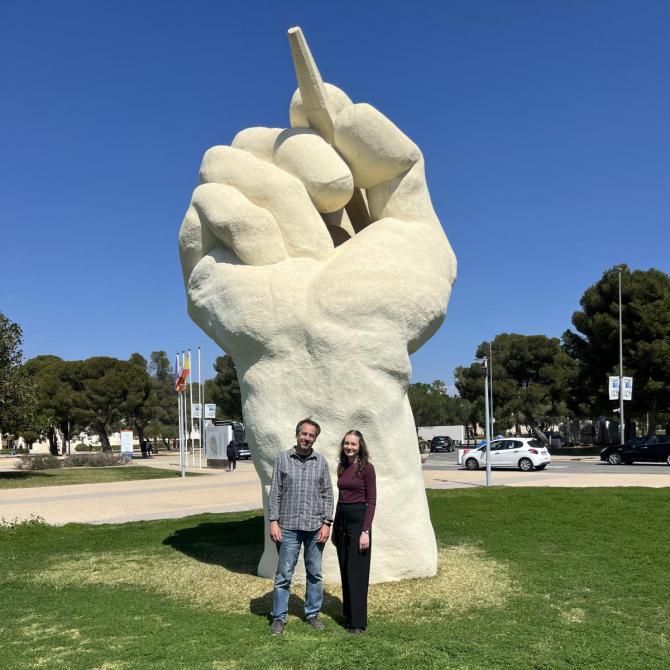
Doktorantka Katarzyna Kusztal i prof. José García-Rodríguez na Uniwersytecie w Alicante
– Zajmuję się klasyfikacją danych rozproszonych. W dużym uproszczeniu chodzi o sytuację, w której interesujące nas dane pochodzą z różnych źródeł. Badam, w jaki sposób można wykorzystywać wiedzę uzyskaną lokalnie, a następnie ją łączyć, aby można było podejmować trafne decyzje bez konieczności traktowania wszystkich danych jako jednego zbioru – mówi Katarzyna Kusztal ze Szkoły Doktorskiej Uniwersytetu Śląskiego.
Jako przykład warto podać dane medyczne zbierane w różnych szpitalach. Wyobraźmy sobie pacjentów, którzy w ramach diagnozy wykonują ten sam pakiet badań laboratoryjnych. Choć ich wyniki trafiają do bardzo podobnych tabel, sama procedura ich przeprowadzania bywa zupełnie inna. Wszystko przez to, że medycyna laboratoryjna zarówno w Polsce, jak i w całej Europie nie jest ustandaryzowana. Szpitale używają różnych technologii i aparatury. Dobrym przykładem jest badanie markera zawału serca. Nawet jeśli dwaj pacjenci z różnych placówek otrzymają identyczny wynik liczbowy, jego interpretacja może być odmienna ze względu na zastosowany analizator oraz powiązane z nim normy.
– Interesuje mnie to, w jaki sposób można wyszukiwać podobne dane z wielu takich źródeł i jak je ze sobą łączyć, aby otrzymać szerszą perspektywę, nie tracąc jednak z oczu istotnych różnic, które bez problemu dostrzeże lekarz – dodaje doktorantka.
W medycynie to wyzwanie jest wyjątkowo trudne ze względu na konieczność ochrony danych wrażliwych. Ponieważ są one rozproszone w szpitalach, przychodniach i laboratoriach, nie można ich po prostu połączyć w jednej centralnej bazie. Byłoby to zbyt ryzykowne. Właśnie dlatego opracowywany algorytm jest tak obiecującym rozwiązaniem.
Model taki pomógłby np. lekarzom szybciej diagnozować nietypowe przypadki i dobierać spersonalizowane leczenie poprzez porównanie profilu pacjenta z tysiącami podobnych historii chorób. Co więcej, być może nawet umożliwiłby wczesne wykrywanie epidemii dzięki uchwyceniu powtarzających się symptomów w różnych szpitalach.
– Warto dodać, że opracowywane przez nas rozwiązanie jest uniwersalne i sprawdzi się też w wielu innych branżach, takich jak finanse. Interesujące są np. dane finansowe dotyczące tego samego zakresu usług. Automatyczna identyfikacja, klasyfikacja i analiza historii kredytowych z różnych banków znacząco przyspieszyłyby pracę analityków na przykład przy wydawaniu decyzji o przyznaniu kredytu – mówi Katarzyna Kusztal.
Z kolei prof. Małgorzata Przybyła-Kasperek zwraca uwagę na znaczenie bezpieczeństwa takich danych.
– Na tym etapie badań nie planujemy ani pozyskiwać, ani udostępniać rzeczywistych danych wrażliwych. Opracowujemy metodę uczenia maszynowego, którą następnie możemy skomercjalizować. Wykorzystujemy więc wyłącznie materiał z ogólnodostępnych repozytoriów. W przyszłości, dopiero na etapie wdrażania, bezpieczeństwem danych zajmą się eksperci specjalizujący się w takich działaniach.
Analiza danych polega na poszukiwaniu podobnych struktur i tworzeniu z nich koalicji. Dzięki temu model może się wyuczyć wzorców, które są nie tylko spójne, lecz także obejmują znacznie szerszy zakres i dzięki temu są dokładniejsze. Prof. Małgorzata Przybyła- Kasperek podkreśla, że są to tzw. modele interpretowane. Oznacza to, że ich wewnętrzna logika oraz sposób podejmowania decyzji powinny być zrozumiałe dla człowieka. Jeśli wobec tego lekarz otrzyma odpowiedź na interesujące go pytanie, będzie miał również możliwość oceny ścieżki decyzyjnej. Takie podejście umożliwia szybsze wychwycenie błędów, co w każdej branży, nie tylko w medycynie czy finansach, ma ogromne znaczenie. Ten algorytm uczenia maszynowego jest więc bezpieczniejszy i wystarczający do analizy danych tabelarycznych, choć nie sprawdzi się przy bardziej złożonych zadaniach związanych chociażby z przetwarzaniem obrazów.
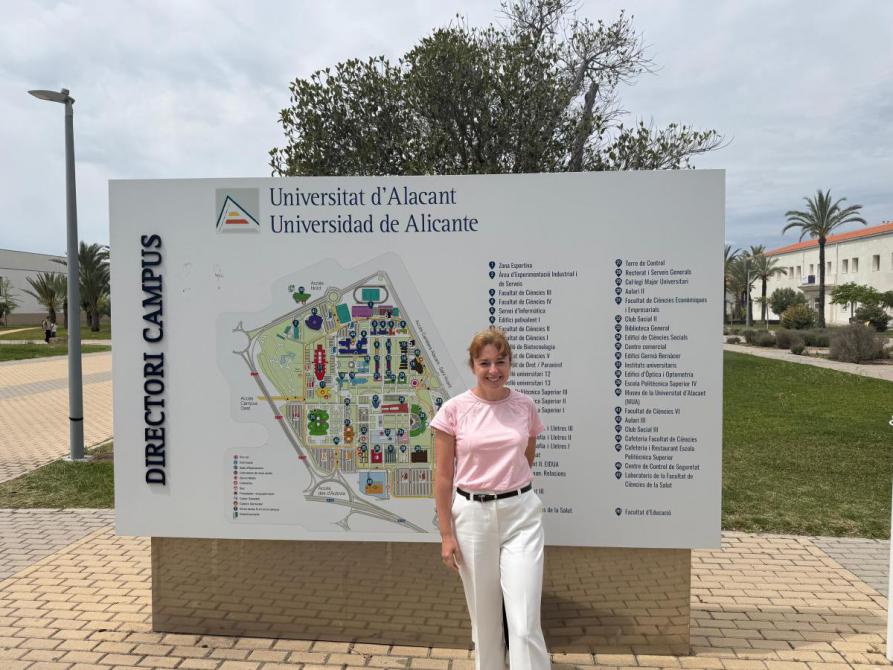
Dr hab. Małgorzata Przybyła-Kasperek, prof. UŚ z Wydziału Nauk Ścisłych i Technicznych UŚ podczas wizyty na Uniwersytecie w Alicante
Takim rozwiązaniem zainteresowani mogą być wszyscy właściciele cyfrowych danych rozproszonych, a więc osoby gromadzące dane o sprzedaży, informacje o lokalizacji przesyłek, operatorzy przetwarzający ruch sieciowy, konsorcja akademickie, administracja publiczna czy chociażby firmy ubezpieczeniowe.
– Opracowaliśmy już część metod do klasyfikacji danych rozproszonych, ale w planach mamy jeszcze kilka kolejnych – podkreśla Katarzyna Kusztal.
Badania prowadzone są we współpracy z prof. Josém Garcíą-Rodríguezem z Uniwersytetu w Alicante.
– Nawiązaliśmy kontakt kilka lat temu dzięki sojuszowi Transform4Europe. Szukaliśmy ośrodka naukowego, który prowadzi badania o zbliżonej tematyce, a jednocześnie ma wysoką pozycję w rankingach w interesującej nas dziedzinie. Dzięki finansowaniu z programu Erasmus+ mogliśmy odwiedzić Alicante i poznać naukowców, z którymi znaleźliśmy wspólny język. W efekcie już wkrótce powstaną nie tylko wspólne publikacje, ale także możemy w naturalny sposób rozwijać wspólne zainteresowania naukowe w ramach nowej formy, jaką jest PhD Track. Dzięki niej w pewnym sensie sformalizowaliśmy współpracę z zespołem z Alicante – mówi prof. Małgorzata Przybyła-Kasperek.
Opracowana przez ekspertów z Uniwersytetu Śląskiego w Katowicach forma PhD Track pozwala doktorantom od samego początku nawiązać międzynarodowe relacje z wybranym naukowcem z uczelni sojuszu T4EU. Pełni on rolę advisora, a jego zadaniem jest wspieranie doktoranta w prowadzeniu badań i budowaniu kariery naukowej.
– O możliwości realizacji doktoratu w formie PhD Track dowiedziałam się od mojej opiekunki naukowej. Doceniam możliwość umiędzynarodowienia naszego projektu na tak wczesnym etapie. Moim advisorem jest właśnie prof. José García-Rodríguez – mówi Katarzyna Kusztal. – Po raz pierwszy spotkaliśmy się w marcu 2026 roku, gdy pojechałam na dwa tygodnie do Alicante. Przedstawiłam swoje badania, otrzymałam też wskazówki i pomysły na rozwijanie metod, nad którymi pracuję. Planujemy też wspólną publikację naukową. Będziemy nad nią pracować podczas kolejnego dwutygodniowego wyjazdu zaplanowanego na październik tego roku – dodaje.
Prof. Małgorzata Przybyła-Kasperek podkreśla, że wypracowany wcześniej kontakt znacząco ułatwił pogłębienie tej współpracy.
– Nasze uczelnie należą do jednego sojuszu. To otwiera drzwi i sprawia, że łatwiej jest sobie zaufać. Pierwsze kontakty pokazują, czy dobrze będzie nam się razem pracowało. Wywiązaliśmy się z umów, pokazaliśmy, że można na nas polegać. Gdy więc wspomniałam Profesorowi o swojej doktorantce, nie zawahał się, od razu zgodził się na taką formę współpracy. Korzyści są obopólne.
– Z jednej strony my poznajemy nowe metody, które możemy wprowadzić u nas, w Polsce. Dowiadujemy się też wiele o wdrażaniu opracowywanych rozwiązań. Z drugiej – naszym wkładem także jest wiedza. „Zawieźliśmy” do Hiszpanii teorię zbiorów przybliżonych polskiego matematyka Zdzisława Pawlaka, która spotkała się z dużym zainteresowaniem. My ją znamy i stosujemy od lat, a teraz, dzięki naszym wysiłkom, będzie ona wykorzystywana w kolejnych ośrodkach Europy. W ten sposób promujemy polską naukę na świecie – dodaje.
Badaczka, podsumowując, zwróciła uwagę na jeszcze jeden ważny aspekt współpracy:
– Rozwój sztucznej inteligencji w Chinach i Stanach Zjednoczonych postępuje w ogromnym tempie. Stoją za nim potężne środki finansowe, którymi my nie dysponujemy. Pracując w mniejszych ośrodkach naukowych w Europie, mamy niewielkie szanse na samodzielną konkurencję z gigantami. Wierzę jednak, że to się zmieni, jeśli postawimy na bliską współpracę międzynarodową – chociażby w ramach takich sojuszy, jak Transform4Europe.
Autorzy: Małgorzata Kłoskowicz
Fotografie: archiwum prywatne
Fotografie: archiwum prywatne
Ten artykuł pochodzi z wydania:
Spis treści wydania
Badania naukoweFelieton literackiFelietonyInformacjeKronika UŚNekrologiWynalazkiWywiad
Zobacz stronę wydania...
Zobacz stronę wydania...